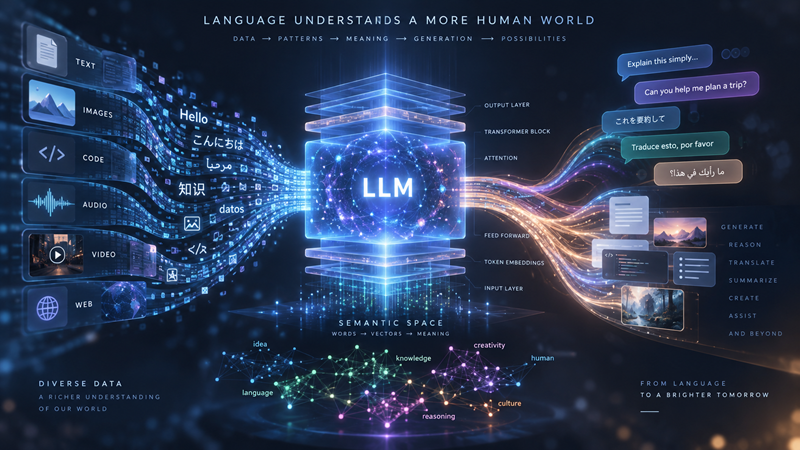
LoRA(Low-Rank Adaptation)は、LLM(大規模言語モデル)を効率的にファインチューニングするための技術です。
事前学習済みのLLMに少数の学習用パラメータを追加することで、元のモデルの重みを原則として変更せずに、特定の業務や用途に合わせてカスタマイズできます。
従来のフルファインチューニングと比較して、学習対象のパラメータ数を大幅に削減できるため、GPUメモリや学習コストを抑えやすい点が特徴です。
例えば、SEO記事の構成を作成するAI、企業独自の文章スタイルを再現するAI、問い合わせ対応を支援するAIなどを開発する際に活用できます。
ただし、LoRAを作成するには、ベースモデルの選定、学習データの準備、学習環境の構築、パラメータの設定、学習結果の評価などが必要です。
ここでは、LoRAの基本的な仕組みから、Pythonを使用した作成方法、具体的な学習手順、QLoRAとの違い、学習精度を高めるポイントまで詳しく解説します。
LoRAとは?
LoRAの基本的な仕組み
LoRAは、事前学習済みのLLMを効率的に追加学習するためのファインチューニング手法です。
通常のフルファインチューニングでは、モデルに含まれる多数のパラメータを更新します。
一方、LoRAでは、元のモデルの重みを固定し、特定の層に追加した小さな行列だけを学習します。
この行列は、低ランク行列と呼ばれるものです。
低ランク行列を利用すると、元の大きな重み行列を直接更新する場合よりも、少ないパラメータでモデルの動作を調整できます。
例えば、すでに日本語を理解できるLLMに、特定の企業が使用する文章スタイルを学習させたい場合を考えてみましょう。
モデル全体を最初から学習し直す必要はありません。
LoRAを使えば、既存モデルの能力を活用しながら、追加したパラメータを通じて望ましい文章表現や回答形式を学習させられます。
ただし、LoRAによって元のモデルの能力が必ず維持されるわけではありません。
学習データや設定によっては、既存の回答性能が低下する場合もあります。
LoRAで学習パラメータを削減できる理由
LoRAの大きな特徴は、学習するパラメータ数を大幅に削減できることです。
例えば、4,096行×4,096列の重み行列を考えます。
通常の学習では、この行列に含まれる約1,678万個のパラメータが更新対象になります。
一方、LoRAのランクを16に設定した場合、追加される学習用パラメータは約13万個です。
つまり、この重み行列に限れば、学習対象のパラメータ数を約99.2%削減できます。
ただし、これは特定の重み行列に対する比較であり、モデル全体のパラメータ数やGPUメモリ使用量が同じ割合で削減されるわけではありません。
学習時には、固定されたベースモデルの重み、活性化データ、勾配、オプティマイザの状態なども扱う必要があるためです。
LoRAとフルファインチューニングの違い
LoRAとフルファインチューニングの最大の違いは、学習時に更新するパラメータの範囲です。
| 比較項目 | LoRA | フルファインチューニング |
|---|---|---|
| 学習対象 | 追加した低ランク行列が中心 | 原則としてモデル全体 |
| GPUメモリ | 比較的少ない | 比較的多い |
| 学習コスト | 抑えやすい | 高くなりやすい |
| 保存容量 | アダプター単体なら小さい | モデル全体の保存が基本 |
| モデルの切り替え | アダプター単位で管理可能 | モデル単位での管理が基本 |
| 学習の自由度 | 更新範囲に制約がある | モデル全体を調整できる |
| 主な用途 | 特定業務や出力形式への適応 | 大規模なモデル全体の調整 |
LoRAは、限られた計算資源を使用して既存のLLMをカスタマイズしたい場合に適しています。
一方、モデル全体に大きな変更を加えたい場合や、十分な計算資源を利用できる場合には、フルファインチューニングも選択肢になります。
LoRAを作成するメリット
GPUメモリの消費量を抑えられる
LoRAの代表的なメリットは、学習時に必要なGPUメモリを削減しやすいことです。
フルファインチューニングでは、多数のパラメータについて勾配やオプティマイザの状態を保持する必要があります。
LoRAでは、追加した少数のパラメータを中心に学習するため、これらのメモリ使用量を抑えられます。
その結果、従来の方法では大容量GPUが必要だったモデルでも、比較的小さなGPU環境で学習できる場合があります。
ただし、必要なメモリは、モデルの規模、入力トークン数、バッチサイズ、学習精度などによって異なります。
学習コストを削減しやすい
LoRAでは、更新対象のパラメータ数が少ないため、フルファインチューニングよりも学習コストを削減できる場合があります。
特に、同じベースモデルを使って複数の業務用AIを開発する場合に役立ちます。
ただし、ベースモデルの計算処理そのものが不要になるわけではありません。
そのため、LoRAを使用すれば必ず学習速度が大幅に向上するというわけではなく、実行環境や学習条件によって効果は変わります。
用途ごとに複数のLoRAを作成できる
LoRAでは、同じベースモデルに対して複数のアダプターを作成できます。
例えば、SEO記事の構成案を生成するLoRA、商品紹介文を生成するLoRA、カスタマーサポート用LoRA、社内文書を要約するLoRAなどです。
このように用途ごとにアダプターを管理すれば、ベースモデル全体を毎回保存する必要性を減らせます。
ただし、アダプターの切り替えには、ベースモデルとの互換性や推論環境側の対応が必要です。
元のベースモデルを維持できる
標準的なLoRAでは、ベースモデルの重みを直接更新しません。
そのため、LoRAアダプターを適用しない状態で、元のモデルを使用できます。
また、学習したアダプターを必要に応じてベースモデルに統合することも可能です。
ただし、LoRAを適用した状態での出力品質は、学習データや設定によって変化します。
追加学習によって、特定のタスクでは性能が改善する一方、別のタスクでは性能が低下する可能性もあります。
LoRAの作成に必要なもの
ベースモデル
LoRAを作成するには、学習の基盤となる事前学習済みLLMが必要です。
代表的なモデルファミリーには、Llama、Qwen、Gemma、Mistralなどがあります。
ベースモデルを選ぶ際は、モデルのパラメータ数、日本語の理解能力、文章生成能力、指示への追従性能、必要なGPUメモリ、ライセンス、学習ツールとの互換性などを確認しましょう。
初めてLoRAを作成する場合は、0.5B~3B程度の小規模モデルから始める方法がおすすめです。
小規模モデルなら、比較的少ない計算資源で学習工程を検証しやすくなります。
ただし、実際の業務で高品質な文章生成や複雑な推論を行いたい場合は、より大きなモデルが必要になることもあります。
学習データセット
LoRAの性能を左右する重要な要素が、学習データの品質です。
一般的な教師ありファインチューニングでは、ユーザーの入力と、その入力に対する望ましい回答を組み合わせたデータを使用します。
例えば、SEO記事タイトルを生成するLoRAなら、キーワードと理想的なタイトル案を対応させます。
入力例
「キーワード『LLM LoRA』でSEO記事タイトルを3つ提案してください。」
回答例
- LLMのLoRAとは?仕組みと活用方法を解説
- LoRAの作り方と具体的な学習手順
- LLMをLoRAで効率的に学習する方法
こうしたデータを蓄積し、モデルに望ましい応答パターンを学習させます。
重要なのは、単にデータ件数を増やすことではありません。
入力と回答の整合性、正確性、出力形式の統一、入力パターンの多様性などを意識する必要があります。
また、個人情報や機密情報が含まれていないか、学習に利用する権利があるかも確認してください。
GPUと学習環境
LoRAの学習には、GPUを使用するのが一般的です。
必要なGPUメモリは、モデルの規模や学習条件によって大きく異なります。
| モデル規模 | LoRAのVRAM検討目安 | QLoRAのVRAM検討目安 |
|---|---|---|
| 0.5B~1B | 8GB前後から | 6~8GB前後から |
| 3B | 12~24GB程度 | 8~12GB程度 |
| 7B~8B | 24~48GB程度 | 12~24GB程度 |
| 13B~14B | 48GB以上の場合もある | 16~32GB程度 |
| 30B以上 | 大容量・複数GPUを検討 | モデルや構成によって大きく異なる |
上記は、短めの入力や小さなバッチサイズなどを想定した大まかな参考値であり、最低動作要件ではありません。
特に、シーケンス長、量子化方式、学習精度、勾配チェックポイントの有無などによって必要なGPUメモリは変化します。
まずは小規模モデルで学習を試し、必要に応じてGPU環境やモデル規模を変更するとよいでしょう。
Pythonと必要なライブラリ
Pythonを使用してLoRAを作成する場合、次のライブラリがよく利用されます。
| ライブラリ | 主な役割 |
|---|---|
| PyTorch | 深層学習の計算 |
| Transformers | 事前学習済みモデルの読み込み |
| PEFT | LoRAの設定とアダプター管理 |
| TRL | 教師ありファインチューニング |
| Datasets | 学習データの読み込みと処理 |
| Accelerate | GPUや分散学習の支援 |
| bitsandbytes | 対応環境での低ビット量子化 |
特に、Hugging FaceのPEFTとTRLを組み合わせることで、比較的少ないPythonコードでLoRAを学習できます。
LoRAを作成する手順
ステップ1:LoRAの学習目的を明確にする
最初に、LoRAで何を実現したいのかを決めます。
例えば、特定の文章スタイルを再現したいのか、指定したJSON形式で回答させたいのか、企業独自の問い合わせ対応方針を学習させたいのかによって、必要なデータが変わります。
ここで重要なのは、LoRAが目的に適した技術なのかを判断することです。
例えば、最新の商品価格や更新される社内規程などを正確に回答させたい場合は、LoRAだけで対応するより、RAGなどを使用して外部情報を参照させる方法が適していることがあります。
LoRAは、回答スタイルや出力形式、タスク固有の振る舞いを調整する用途に向いています。
ステップ2:ベースモデルを選ぶ
学習目的が決まったら、ベースモデルを選びます。
今回は実装例として、比較的小規模なQwen/Qwen2.5-0.5B-Instructを使用します。
このモデルは、指示に従った回答を生成するために調整されたInstructモデルです。
比較的小さいため、LoRAの仕組みや学習工程を検証する用途に適しています。
ただし、高度な日本語文章生成や複雑な業務タスクでは、より大きなモデルのほうが高い性能を示す場合があります。
ステップ3:学習データを作成する
次に、学習用データを用意します。
チャット向けLLMを学習する場合は、ユーザーの入力とアシスタントの回答を会話形式で管理すると、推論時との整合性を取りやすくなります。
例えば、次のようなJSON形式です。
{
  "prompt": [
    {
      "role": "user",
      "content": "キーワード:LLM LoRA。SEO記事タイトルを3つ提案してください。"
    }
  ],
  "completion": [
    {
      "role": "assistant",
      "content": "1. LLMのLoRAとは?仕組みを解説\n2. LoRAの作り方と学習手順\n3. LLMをLoRAで効率的に学習する方法"
    }
  ]
}この形式では、promptにユーザーの入力、completionに理想的な回答を記述します。
学習データは、1行に1つのJSONオブジェクトを格納するJSONL形式で保存すると扱いやすくなります。
例えば、train.jsonlというファイルを作成します。
{"prompt":[{"role":"user","content":"キーワード:LLM LoRA。SEO記事タイトルを3つ提案してください。"}],"completion":[{"role":"assistant","content":"1. LLMのLoRAとは?仕組みを解説\n2. LoRAの作り方と学習手順\n3. LLMをLoRAで効率的に学習する方法"}]}
{"prompt":[{"role":"user","content":"キーワード:生成AI マーケティング。SEO記事タイトルを3つ提案してください。"}],"completion":[{"role":"assistant","content":"1. 生成AIをマーケティングに活用する方法\n2. 生成AIマーケティングのメリットと注意点\n3. 生成AIによるマーケティング業務の効率化"}]}
この例は、あくまでデータ形式を説明するためのものです。
2件だけでは、実用的なLoRAの学習や性能評価はできません。
実際には、目的に合わせて十分な件数を用意する必要があります。
また、学習データの文章表現や出力形式が不統一だと、モデルの出力も安定しにくくなるため注意しましょう。
ステップ4:学習用データと評価用データに分割する
用意した学習データは、学習用と評価用に分けます。
例えば、1,000件のデータを用意した場合、900件を学習用、100件を検証用にする方法があります。
評価用データは、モデルが学習していない入力に対応できるか確認するために使用します。
学習データに対する性能だけを見ても、モデルが訓練例を記憶しているだけなのか、新しい入力にも対応できるのかを判断できません。
なお、学習用と評価用に似たデータが大量に含まれると、評価結果が実際より良く見える可能性があります。
本格的な運用では、学習用、検証用、最終テスト用に分割する方法も有効です。
PythonでLoRAを作成する具体的な方法
ここからは、PythonとHugging Faceのライブラリを使用したLoRAの実装方法を紹介します。
学習には、PEFTのLoraConfigとTRLのSFTTrainerを使用します。
以下のコードは、CUDA対応NVIDIA GPUを利用する環境を想定した基本例です。
ライブラリのAPIは更新されるため、実行時には対応するバージョンの組み合わせも確認してください。
ステップ5:Python環境を構築する
まず、Pythonの仮想環境を作成します。
python -m venv lora-envLinuxまたはmacOSの場合は、次のコマンドで有効化します。
source lora-env/bin/activateWindowsのPowerShellの場合は、次のコマンドを使用します。
.\lora-env\Scripts\Activate.ps1続いて、必要なライブラリをインストールします。
pip install --upgrade pip
pip install torch transformers datasets accelerate peft trl safetensors
PyTorchについては、使用するGPUやCUDA環境に適したビルドを選んでください。
GPUが認識されているかどうかは、次のコードで確認できます。
import torchprint(torch.cuda.is_available())if torch.cuda.is_available(): print(torch.cuda.get_device_name(0))Trueが表示されれば、PyTorchからCUDA対応GPUを利用できる状態です。
ステップ6:LoRAの学習コードを作成する
次に、train_lora.pyというPythonファイルを作成します。
以下のコードでは、学習データの読み込み、データの分割、LoRAの設定、学習、保存までを実行します。
import torchfrom datasets import load_datasetfrom peft import LoraConfigfrom transformers import AutoTokenizerfrom trl import SFTConfig, SFTTrainer# ベースモデルmodel_name = "Qwen/Qwen2.5-0.5B-Instruct"# GPUの確認if not torch.cuda.is_available(): raise RuntimeError( "CUDA対応GPUが必要です。" )# 学習データの読み込みdataset = load_dataset( "json", data_files="train.jsonl", split="train")# データ件数の確認if len(dataset) < 20: raise ValueError( "この例では20件以上のデータを" "用意してください。" )# データを学習用と検証用に分割split_dataset = dataset.train_test_split( test_size=0.1, seed=42)train_dataset = split_dataset["train"]このコードでは、会話形式のprompt-completionデータを使用することを想定しています。
completion_only_loss=Trueを設定することで、対応するデータ形式では、ユーザーの入力ではなくアシスタントの回答部分を中心に学習できます。
また、gradient_checkpointing=Trueは、学習時のメモリ使用量を削減するための設定です。
ただし、追加の計算が必要になるため、学習速度が低下する場合があります。
なお、コード内の20件という条件は、極端に少ないデータを検出するための暫定的な値です。
20件あれば十分な学習や評価ができるという意味ではありません。
また、このコードは基本的な学習構成を示したものであり、すべてのGPU環境での動作を保証するものではありません。
ステップ7:LoRAの学習を実行する
コードを保存したら、次のコマンドで学習を開始します。
python train_lora.py学習が始まると、進捗や損失などが表示されます。
代表的な指標は次のとおりです。
| 指標 | 意味 |
|---|---|
| loss | 学習データに対する損失 |
| eval_loss | 評価データに対する損失 |
| epoch | 学習データを何周したか |
| learning_rate | 現在の学習率 |
| grad_norm | 勾配の大きさを表す指標 |
一般的には、学習が進むと損失が低下する傾向があります。
ただし、損失が低下したからといって、必ずしも回答品質が改善しているとは限りません。
特に、学習損失が低下している一方で評価損失が悪化している場合は、過学習の可能性があります。
そのため、数値だけでなく、実際に生成される文章の品質も確認することが重要です。
ステップ8:学習したLoRAを保存する
学習が完了したら、LoRAアダプターを保存します。
先ほどのコードでは、次の処理によって保存します。
trainer.save_model("./my_lora")tokenizer.save_pretrained("./my_lora")保存先には、一般的に次のようなファイルが生成されます。
my_lora/
├── adapter_config.json
├── adapter_model.safetensors
├── tokenizer_config.json
└── その他の設定ファイルadapter_model.safetensorsには、LoRAで学習したパラメータが格納されます。
adapter_config.jsonには、ランクや適用対象などの設定情報が記録されます。
実際のファイル構成は、ライブラリのバージョンや保存方法によって異なります。
なお、LoRAアダプターだけでは、通常は完全なLLMとして動作しません。
推論時には、学習に使用したベースモデルと組み合わせる必要があります。
ステップ9:学習したLoRAで文章を生成する
保存したLoRAアダプターは、ベースモデルに読み込ませることで推論に使用できます。
例えば、次のようなPythonコードです。
import torchfrom transformers import ( AutoModelForCausalLM, AutoTokenizer)from peft import PeftModel# ベースモデルとLoRAの指定model_name = "Qwen/Qwen2.5-0.5B-Instruct"lora_path = "./my_lora"# トークナイザーの読み込みtokenizer = AutoTokenizer.from_pretrained( model_name)# ベースモデルを読み込むmodel = AutoModelForCausalLM.from_pretrained( model_name, dtype="auto", device_map="auto")# LoRAアダプターを適用model = PeftModel.from_pretrained( model, lora_path)model.eval()# 入力する質問messages = [ { "role": "user", "content": (このように、学習したLoRAアダプターをベースモデルに適用することで、追加学習の結果を利用できます。
推論時には、ベースモデル単体の出力とLoRA適用後の出力を比較すると、学習の効果を確認しやすくなります。
なお、学習時と推論時で入力形式が異なると、期待した性能が得られない場合があります。
特にチャット向けLLMでは、モデル固有のチャットテンプレートを適切に使用することが重要です。
LoRAの学習で重要なハイパーパラメータ
LoRAの学習性能は、データの品質だけでなく、ハイパーパラメータの設定にも左右されます。
特に重要なのは、ランク、Alpha、学習率、エポック数、バッチサイズ、LoRAの適用対象です。
ランク(r)
ランクは、LoRAで追加する低ランク行列の大きさを決めるパラメータです。
ランクが大きいほど、一般的には学習対象のパラメータ数が増え、重みを調整する自由度が高くなります。
| ランク | 特徴 |
|---|---|
| r=4 | 学習パラメータが少なく、軽量な実験に向く |
| r=8 | 比較的低コストで学習できる |
| r=16 | 初期設定の候補として使いやすい |
| r=32 | 重み更新の自由度が高くなる |
| r=64 | より多くのパラメータを学習できる |
ただし、ランクを大きくすれば、必ず性能が向上するわけではありません。
データ量や学習対象によって適切な値は異なります。
初めてLoRAを作る場合は、r=8やr=16などから試す方法があります。
Alpha(lora_alpha)
Alphaは、LoRAによる重みの更新量を調整するパラメータです。
ランクと組み合わせて設定し、追加したパラメータがモデルの出力に与える影響を調整します。
例えば、次のような設定が考えられます。
r=16lora_alpha=32この組み合わせは、LoRAの初期設定の候補として使用できます。
ただし、すべてのモデルやタスクに最適というわけではありません。
また、rsLoRAなどの派生手法では、スケーリング方法が異なります。
学習率(learning_rate)
学習率は、学習中にパラメータをどの程度更新するかを決める値です。
学習率が大きすぎると学習が不安定になる場合があり、小さすぎると十分に学習が進まない可能性があります。
LoRAでは、次のような値が初期設定や調整の候補になります。
| 学習率 | 特徴 |
|---|---|
| 5e-5 | 比較的小さな更新 |
| 1e-4 | 初期設定の候補 |
| 2e-4 | やや大きな更新 |
| 3e-4 | 学習状況を確認しながら検証する値 |
LoRAでは、フルファインチューニングよりも大きめの学習率を使用することがあります。
ただし、モデルやデータセットによって適切な値は変わるため、評価結果を確認しながら調整しましょう。
エポック数(num_train_epochs)
エポック数は、学習データ全体を何回繰り返して学習するかを表します。
例えば、1,000件のデータを3エポック学習する場合、基本的にはデータ全体を3回使用します。
エポック数が少なすぎると十分に学習できず、多すぎると過学習が起こる可能性があります。
初期設定では1~3エポック程度から試し、評価損失や回答品質を確認しながら調整するとよいでしょう。
バッチサイズと勾配累積
バッチサイズは、一度に処理する学習サンプル数です。
バッチサイズが大きいほど、多くのサンプルをまとめて処理できますが、一般的にはGPUメモリの使用量も増加します。
GPUメモリが限られている場合は、小さなバッチサイズと勾配累積を組み合わせる方法があります。
例えば、次の設定です。
per_device_train_batch_size=1gradient_accumulation_steps=4この設定では、1デバイスあたり1サンプルずつ処理し、4回分の勾配を累積してからパラメータを更新します。
これにより、メモリ使用量を抑えながら、実効的に複数サンプル分の勾配をまとめて更新に使用できます。
ただし、勾配累積を使用しても、学習速度や数値的な振る舞いが完全に同じになるとは限りません。
LoRAの適用対象(target_modules)
LoRAでは、モデル内のどの層にアダプターを追加するかを設定できます。
例えば、Attention層の一部を対象とする場合は、次のように指定します。
target_modules=["q_proj", "v_proj"]一方、対象モデルの線形層を広く指定したい場合は、次の設定を使用できます。
target_modules="all-linear"all-linearは、PEFTでサポートされている指定方法です。
通常のTransformersモデルでは、出力層を除く線形層が主な対象となります。
適用範囲を広げると、一般的には学習するパラメータ数が増えます。
そのため、GPUメモリや学習時間とのバランスを考えて設定することが重要です。
LoRAとQLoRAの違い
QLoRAとは?
QLoRA(Quantized Low-Rank Adaptation)は、量子化とLoRAを組み合わせたファインチューニング手法です。
一般的なLoRAでは、ベースモデルの重みをFP16やBF16などの形式で保持することがよくあります。
一方、QLoRAでは、ベースモデルの重みを主に4ビットに量子化して保持します。
その上で、LoRAアダプターを学習します。
量子化によってベースモデルの保持に必要なメモリを削減できるため、比較的小さなGPU環境でも大きなLLMを学習しやすくなります。
ただし、QLoRAでは、すべての計算が4ビットで実行されるわけではありません。
実際の演算には、FP16やBF16などの計算精度も使用されます。
LoRAとQLoRAの比較
| 比較項目 | LoRA | QLoRA |
|---|---|---|
| ベースモデル | 通常は非量子化 | 主に4ビット量子化 |
| 学習対象 | LoRAアダプター | LoRAアダプター |
| GPUメモリ | 比較的多い | 削減しやすい |
| 学習速度 | 実行環境による | 量子化処理の影響を受ける |
| 出力品質 | モデルや設定に依存 | 量子化誤差の影響を受ける場合がある |
| 主な用途 | 通常の効率的な追加学習 | メモリ制約のある環境での追加学習 |
QLoRAは、特にGPUメモリが不足する場合に有力な選択肢です。
ただし、量子化による追加処理があるため、通常のLoRAより必ず高速になるわけではありません。
QLoRAの実装方法
QLoRAを使用する場合は、ベースモデルを量子化して読み込みます。
Hugging FaceのTransformersでは、BitsAndBytesConfigを使用して4ビット量子化を設定できます。
最初に、対応する環境でbitsandbytesをインストールします。
pip install bitsandbytes次に、以下のように量子化モデルを読み込みます。
import torchfrom transformers import ( AutoModelForCausalLM, BitsAndBytesConfig)from peft import prepare_model_for_kbit_trainingmodel_name = "Qwen/Qwen2.5-0.5B-Instruct"# GPUの計算精度compute_dtype = ( torch.bfloat16 if torch.cuda.is_bf16_supported() else torch.float16)# 4ビット量子化の設定quantization_config = BitsAndBytesConfig( load_in_4bit=True, bnb_4bit_quant_type="nf4", bnb_4bit_compute_dtype=compute_dtype, bnb_4bit_use_double_quant=True)# 量子化モデルを読み込むmodel = AutoModelForCausalLM.from_pretrained( model_name, quantization_config=quantization_config, device_map="auto")# 低ビット学習向けの準備model = prepare_model_for_kbit_training(model)このコードは、QLoRA学習のために量子化モデルを準備する部分です。
実際の学習では、さらにLoraConfigやSFTTrainerを組み合わせる必要があります。
また、NF4はQLoRAでよく利用される4ビット量子化形式です。
二重量子化を有効にすると、量子化に必要な追加情報をさらに圧縮し、メモリ使用量を抑えられる場合があります。
なお、QLoRAの動作には、対応するGPUやライブラリが必要です。
LoRAの学習精度を高めるポイント
学習データの品質を優先する
LoRAの品質を高めるためには、学習データの正確性と一貫性が重要です。
大量のデータを用意しても、誤った回答や不適切な出力形式が含まれていると、期待した性能が得られない可能性があります。
特に、入力と回答が正しく対応しているか、文章に事実誤認がないか、出力形式が統一されているか、同じようなデータが過剰に重複していないかを確認してください。
また、学習目的に関係のないデータを大量に混在させると、期待した回答スタイルが安定しない場合があります。
学習データに多様性を持たせる
同じ入力パターンばかり学習すると、モデルの応答が特定の表現に偏る可能性があります。
例えば、SEO記事タイトルを生成するLoRAなら、キーワードの種類、検索意図、想定読者、記事ジャンル、タイトルの文字数などを変えたデータを用意します。
ただし、データの多様性を増やすために、目的と無関係な情報を大量に追加する必要はありません。
実際の利用場面で必要となる入力パターンを中心にデータを整備することが重要です。
ベースモデルと学習後のモデルを比較する
LoRAの学習後は、ベースモデルとLoRAを適用したモデルの出力を比較しましょう。
例えば、次のような項目で評価できます。
| 評価項目 | 確認内容 |
|---|---|
| 指示追従性能 | 指示された内容に従っているか |
| 出力形式 | 指定された形式で回答するか |
| 正確性 | 事実に誤りがないか |
| 日本語品質 | 不自然な表現がないか |
| 一貫性 | 回答ルールが統一されているか |
| 汎化性能 | 未学習の質問にも対応できるか |
同じ評価用データで比較すると、学習によって改善した能力と、逆に低下した能力を把握しやすくなります。
また、最終的な品質を判断する際は、損失の数値だけでなく、実際に生成された回答の内容も確認することが大切です。
過学習を防ぐ
LoRAでは、少量のデータを何度も学習すると、過学習が起こる可能性があります。
過学習とは、学習データには適切に対応できる一方、未知の入力に対する性能が低下する状態です。
例えば、学習損失は低下するものの評価損失が悪化したり、学習データと似た回答ばかり生成したりする場合があります。
対策としては、エポック数の削減、学習率の調整、データの改善、早期終了などがあります。
LoRAの学習でよくある失敗と対処法
GPUメモリ不足になる
学習中にCUDA out of memoryというエラーが表示される場合があります。
これは、利用可能なGPUメモリに対して、学習処理で必要なメモリが不足している状態です。
対処法としては、バッチサイズを小さくする、シーケンス長を短くする、勾配チェックポイントを有効にする、より小規模なモデルを使用する、QLoRAを導入するといった方法があります。
初めて学習を実行する場合は、まず小規模モデルと短い入力で正常に動作するか確認することをおすすめします。
学習しても回答品質が改善しない
LoRAを学習しても、期待した回答が得られない場合があります。
主な原因として、学習データの不足、データ品質の問題、学習率の設定、学習目的とベースモデルの能力の不一致などが考えられます。
また、学習時と推論時の入力形式が異なる場合も、性能に影響する可能性があります。
特にチャット向けLLMでは、学習時と推論時で対応するチャットテンプレートを使用し、入力形式を揃えることが重要です。
LoRAアダプターを読み込めない
学習済みLoRAを読み込む際にエラーが発生した場合は、ベースモデルとLoRAの互換性を確認してください。
LoRAは、原則として学習時に使用したベースモデルの構造や重みに依存します。
そのため、異なるLLMにそのまま適用できるとは限りません。
また、保存ファイルの不足、ライブラリの互換性、トークナイザーの設定なども確認する必要があります。
LoRAの主な活用方法
SEO記事やWebコンテンツの生成
LoRAは、特定の文章スタイルや編集ルールに沿ったWebコンテンツを生成する用途に活用できます。
例えば、企業独自の編集方針を学習させ、SEO記事の見出し構成、メタディスクリプション、商品紹介文、広告文などを生成する方法があります。
特に、出力形式や文章トーンを統一したい場合に役立ちます。
ただし、LoRAを使用するだけで検索順位が向上するわけではありません。
コンテンツの正確性、独自性、有用性、検索意図との一致度などを別途確認することが重要です。
カスタマーサポート
LoRAは、企業独自の問い合わせ対応ルールや文章スタイルを学習させる用途にも利用できます。
例えば、丁寧な敬語で回答する、指定した形式で案内する、問い合わせを分類するなどのタスクです。
ただし、返品条件、料金、サービス内容など、頻繁に更新される情報については、LoRAだけに依存しないほうが適切な場合があります。
最新情報が必要な場合は、RAGや業務システムとの連携を検討しましょう。
社内業務の自動化
LoRAは、社内文書の要約、議事録の整理、定型レポートの作成、問い合わせ分類などにも活用できます。
特定の文書形式や回答ルールを学習させることで、業務に適した文章を生成しやすくなります。
ただし、学習データに機密情報が含まれる場合は、保存先やアクセス権限、モデルの配布範囲などを適切に管理する必要があります。
LoRAに関するよくある質問
LoRAの学習には何件のデータが必要?
必要なデータ件数に一律の基準はありません。
単純な出力形式の調整であれば、数十~数百件程度の高品質なデータから改善が見られる場合もあります。
一方、複雑な業務タスクや多様な質問への対応では、数千件以上のデータが必要になることもあります。
重要なのは、データ件数だけで判断せず、未学習データに対する評価結果を確認することです。
LoRAはCPUだけでも作れる?
小規模モデルであれば、CPUだけでLoRAを学習できる場合があります。
ただし、GPUを利用する場合と比較して、学習時間が長くなることが一般的です。
実用的な速度で学習したい場合は、対応するGPUを利用する方法が適しています。
LoRAは異なるLLMでも使い回せる?
原則として、LoRAは学習時に使用したベースモデルに依存します。
そのため、あるLLM向けに作成したLoRAを、別のLLMにそのまま適用できるとは限りません。
同じモデルファミリーであっても、モデルサイズや内部構造が異なる場合は互換性がないことがあります。
LoRAをベースモデルに統合できる?
はい。
対応するLoRAでは、学習した重みをベースモデルに統合できます。
PEFTでは、次のように記述できます。
merged_model = model.merge_and_unload()merged_model.save_pretrained( "./merged_model")統合後は、LoRAアダプターを別途読み込まずに利用できるモデルとして保存できます。
ただし、統合後の保存容量はベースモデル全体に相当します。
また、量子化モデルや特殊なアダプター構成では、統合に制約がある場合があります。
LoRAとRAGはどちらを使うべき?
LoRAとRAGは役割が異なるため、目的に応じて使い分けることが重要です。
| 目的 | 適した技術 |
|---|---|
| 文章スタイルを統一する | LoRA |
| 出力形式を学習させる | LoRA |
| 最新情報を参照する | RAG |
| 社内文書を根拠に回答する | RAG |
| 独自の回答スタイルと情報検索を両立する | LoRA+RAG |
LoRAは、主にモデルの振る舞いを調整する技術です。
一方、RAGは外部情報を検索し、その情報を回答生成に活用する技術です。
両方を組み合わせることで、独自の文章スタイルを維持しながら、更新される情報を参照するシステムを構築できます。
まとめ
LoRAは、事前学習済みLLMの重みを原則として固定し、追加した少数のパラメータを学習するファインチューニング手法です。
フルファインチューニングと比較して、学習パラメータ数やGPUメモリの使用量を削減しやすく、限られた計算資源でもLLMをカスタマイズできる点が特徴です。
LoRAを作成するには、まず学習目的を明確にし、適切なベースモデルと高品質な学習データを準備します。
その後、PythonやHugging FaceのPEFT、TRLなどを使用して学習を実行し、評価用データで性能を確認します。
また、GPUメモリが不足する場合は、4ビット量子化とLoRAを組み合わせたQLoRAも有力な選択肢となります。
LoRAの品質を高めるには、ランクや学習率などの設定だけでなく、学習データの正確性、入力形式の統一、未学習データによる評価を重視することが大切です。
まずは小規模モデルを使用して学習工程を確認し、その結果をもとにデータや設定を改善していくことで、効率的に実用性の高いLoRAを開発できるでしょう。
以上、LLMでLoRAを作る方法や学習手順についてでした。
最後までお読みいただき、ありがとうございました。