LLM Visionは、AIが画像や写真、図表などの視覚情報を理解し、自然言語による質問への回答や情報の分析を行う技術です。
従来の大規模言語モデル(LLM)は主にテキストを処理していましたが、Vision機能を備えたモデルでは、画像とテキストを組み合わせた処理が可能です。
例えば、写真に写っている物体の認識、画像内の文字の読み取り、グラフの分析、Webサイトのスクリーンショットの評価など、さまざまな用途に活用できます。
一方で、画像の認識精度や推論能力には限界があり、すべての情報を正確に読み取れるわけではありません。
この記事では、LLM Visionの意味や仕組み、できること、主要な技術、従来の画像認識AIとの違い、活用事例、メリット・デメリット、効果的な使い方について詳しく解説します。
LLM Visionとは?
LLM Visionの意味と定義
LLM Visionとは、LLM(Large Language Model:大規模言語モデル)が画像などの視覚情報を処理し、その内容に基づいて文章を生成したり、質問に回答したりする機能や技術を指す表現です。
LLMは、大量のデータを使って学習し、文章の生成、要約、翻訳、質問応答などを行うAIモデルです。
一方、Visionは、画像や映像などの視覚情報をコンピューターで処理・解析する技術を意味します。
これらを組み合わせることで、AIは文章だけでなく、画像に含まれる情報も利用できるようになります。
例えば、料理の写真を入力して「どのような食材が使われているように見えますか?」と質問すると、AIは画像から読み取れる特徴をもとに回答を生成できます。
ただし、LLM Visionは学術的に厳密に統一されたモデルの分類名ではありません。
一般的には、画像理解機能を備えたLLMや、視覚情報と言語情報を組み合わせるAI技術を指す文脈で使用されます。
LLM VisionとVLMの違い
LLM Visionと関連性が高い用語に、VLM(Vision-Language Model:視覚言語モデル)があります。
VLMは、画像などの視覚情報と言語情報を関連付けて処理するAIモデルの総称です。
LLMを基盤とするVLMもありますが、すべてのVLMが大規模言語モデルを中心に構成されているわけではありません。
例えば、画像と文章の意味的な対応関係を学習するCLIPも、視覚と言語を扱う代表的なモデルです。
ただし、CLIP自体は一般的な対話型LLMではありません。
そのため、LLM VisionとVLMは密接に関連していますが、完全な同義語ではない点を理解しておく必要があります。
LLM VisionとマルチモーダルAIの関係
LLM Visionは、マルチモーダルAIを実現する技術の一つです。
マルチモーダルAIとは、テキスト、画像、音声、動画など、異なる種類の情報を組み合わせて処理するAIです。
例えば、画像を見ながら質問に回答する機能は、視覚と言語を組み合わせたマルチモーダル処理に該当します。
主な関連用語の違いは、以下のとおりです。
| 用語 | 意味・特徴 |
|---|---|
| LLM | 主に自然言語の理解や生成を行う大規模モデル |
| Computer Vision | 画像や映像の認識・解析を扱う技術分野 |
| LLM Vision | LLMに画像理解能力を組み合わせた機能や技術 |
| VLM | 視覚情報と言語情報を関連付けて処理するモデル |
| マルチモーダルAI | 複数種類の情報を処理するAIの総称 |
LLM Visionは、マルチモーダルAIの発展を支える重要な技術の一つといえます。
LLM Visionの仕組み
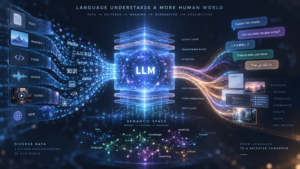
LLM Visionでは、画像をモデルが処理できる数値表現に変換し、その情報をテキストと関連付けることで、画像の内容を理解します。
モデルの内部構造にはさまざまな種類がありますが、代表的な方式では、Vision EncoderとLLMを接続する構成が採用されています。
基本的な処理の流れは、以下のとおりです。
- 画像と質問文を入力する
- 画像の特徴を抽出する
- 視覚情報と言語情報を統合する
- LLMが画像と質問文の関係を処理する
- 自然言語による回答を生成する
ただし、これは代表的なモデル構造を簡略化したものであり、すべてのLLM Visionが同じ仕組みを採用しているわけではありません。
1. 画像とテキストを入力する
最初に、ユーザーが画像や質問文をAIに入力します。
入力できる画像には、写真、イラスト、グラフ、表、文書、スクリーンショットなどがあります。
例えば、商品の写真を入力して「この商品の色やデザインの特徴を説明してください」と指示できます。
このとき、モデルやサービスによっては、画像サイズの調整、画素値の正規化、画像の分割などの前処理が行われます。
高解像度画像を複数の領域に分けて処理する方式もあります。
2. Vision Encoderで画像の特徴を抽出する
代表的なLLM Visionの構成では、Vision Encoder(画像エンコーダー)を使用します。
Vision Encoderは、画像に含まれる形状、色、模様、物体の特徴などを数値表現に変換する仕組みです。
この数値表現は、画像の特徴ベクトルなどと呼ばれます。
例えば、猫の写真であれば、耳の形、目の位置、毛並み、背景との関係などに対応する視覚的特徴が数値表現に反映されます。
ただし、AIが人間と同じ方法で画像を理解しているわけではありません。
モデルは、学習によって獲得した特徴表現やパターンを利用して情報を処理しています。
3. 画像情報をLLMが処理できる形式に変換する
Vision Encoderによって抽出された画像の特徴は、必要に応じてLLMが利用できる形式に変換されます。
代表的な構成では、Projector(プロジェクター)と呼ばれる変換層が使用されます。
Projectorは、画像エンコーダーの出力を、LLMが処理できる表現へ変換する役割を持ちます。
また、Cross-Attentionなどを利用して視覚情報と言語情報を関連付ける方式もあります。
ただし、すべてのLLM Visionが独立したVision EncoderやProjectorを使用するわけではありません。
画像と言語をより統合的に処理するアーキテクチャも存在します。
4. LLMが視覚情報と質問文を処理する
画像の特徴と言語情報を関連付けた後、LLMが質問文に応じて情報を処理します。
例えば、室内の写真について「この部屋にはどのような家具がありますか?」と質問した場合、画像から読み取れる家具の特徴をもとに回答します。
さらに「この部屋のインテリアを改善する方法を提案してください」と質問すれば、画像の情報と学習済みの知識を組み合わせて改善案を生成できます。
このように、単純な物体認識だけでなく、視覚情報に基づく説明や推論が可能になります。
5. 自然言語で回答を生成する
最後に、モデルが処理した情報をもとに回答を生成します。
回答は文章だけでなく、モデルやシステムの機能によっては表形式やJSONなどの構造化データとして出力できます。
例えば、画像から読み取った商品情報を、商品名、色、形状、特徴などの項目に整理することも可能です。
ただし、出力形式が整っていても、内容の正確性が保証されるわけではありません。
重要な情報については、元画像や関連資料との照合が必要です。
LLM Visionで使われる主な技術
LLM Visionには、画像認識と言語処理を組み合わせるためのさまざまな技術が利用されています。
ここでは、代表的な技術を紹介します。
Vision Transformer(ViT)
Vision Transformerは、Transformerの仕組みを画像処理に応用したモデルです。
代表的な方式では、画像を小さな領域であるパッチに分割し、それぞれのパッチを数値表現へ変換します。
その後、Transformerを使用して各パッチの特徴や相互関係を処理します。
例えば、画像の左側に人物、右側に自転車が写っている場合、画像内の異なる領域の関係を捉えるために利用できます。
ViTは、画像処理分野で広く研究・活用されている技術の一つです。
CLIP
CLIP(Contrastive Language–Image Pre-training)は、画像とテキストの意味的な関連性を学習するモデルです。
画像エンコーダーとテキストエンコーダーを使用し、対応する画像と文章の特徴表現が近くなり、対応しない組み合わせは相対的に区別できるように学習します。
この学習方法は、対照学習と呼ばれます。
例えば、犬の写真と「犬が芝生の上を走っている」という文章の関連性を数値的に評価できます。
CLIPは、ゼロショット画像分類や画像検索などに応用できる技術です。
ただし、CLIP自体は一般的な対話型LLMではありません。
Cross-Attention
Cross-Attentionは、異なる情報系列の間で関連性を計算する仕組みです。
視覚情報と言語情報を組み合わせる際に利用されることがあります。
例えば、「画像の右側にある赤いバッグを説明してください」という質問に対して、質問文と関連性の高い視覚情報を参照する仕組みに利用できます。
ただし、Cross-AttentionはすべてのLLM Visionに必須の構成要素ではありません。
Visual Instruction Tuning
Visual Instruction Tuningは、画像と指示文、それに対応する回答などを使い、モデルが視覚情報を踏まえた指示に対応できるよう学習させる手法です。
例えば、画像と「写真に写っているものを説明してください」という指示、適切な回答を組み合わせたデータを利用します。
これにより、画像の説明、視覚的質問応答、画像に基づく推論などの能力向上を目指します。
LLaVAは、このような学習方法を活用した代表的な研究モデルです。
画像トークン
LLM Visionを理解するうえでは、画像トークンの概念も重要です。
LLMは、一般的にテキストをトークンと呼ばれる単位で処理します。
画像対応モデルでは、画像情報もモデル内部でトークンに相当する表現として扱われる場合があります。
画像の解像度やモデルの処理方式によって、必要なトークン数や計算量が変化することがあります。
ただし、画像パッチと画像トークンが必ず一対一で対応するわけではありません。
また、画像情報をどのように表現・処理するかは、モデルの設計によって異なります。
LLM Visionでできること
LLM Visionには、画像認識から文章生成まで、幅広い機能があります。
代表的な機能を詳しく紹介します。
画像に写っている物体の認識
LLM Visionは、画像に写っている物体の種類や特徴を説明できます。
例えば、果物の写真からリンゴやバナナなどを認識したり、室内の写真から家具の種類を説明したりできます。
また、物体同士の位置関係や画像全体の状況について質問することも可能です。
ただし、小さな物体や複雑に重なった物体、正確な個数の認識では誤りが発生する場合があります。
画像の内容を文章で説明する
LLM Visionは、画像の内容を自然な文章に変換できます。
このような処理は、Image Captioning(画像キャプション生成)と呼ばれます。
例えば、風景写真を入力すると、写っている建物、自然、人物、天候など、視覚的に確認できる特徴を文章で説明できます。
Webサイトの画像説明文や、アクセシビリティ向上のための代替テキスト作成にも活用できます。
ただし、写真から判断できない撮影場所や人物の感情などを推測してしまう場合があるため、内容の確認が必要です。
画像内の文字の読み取り
LLM Visionは、画像に含まれる文字を読み取り、その内容を整理できます。
例えば、領収書、請求書、ホワイトボード、商品パッケージ、スクリーンショットなどから文字情報を抽出できます。
さらに、読み取った文章を要約したり、必要な情報だけを整理したりすることも可能です。
この機能は、OCR(Optical Character Recognition:光学文字認識)と関連しています。
ただし、OCRとLLM Visionは同一の技術ではありません。
OCRは主に文字の認識・抽出を目的とするのに対し、LLM Visionは画像の内容や文脈を踏まえて文章の解釈や質問応答を行える点が特徴です。
なお、正確な文字の読み取りが必要な場合には、専用OCRの方が適していることもあります。
グラフや表の分析
LLM Visionは、棒グラフ、折れ線グラフ、円グラフ、表などの内容を分析できます。
例えば、売上推移のグラフを入力して「売上が増加している時期を教えてください」と質問できます。
さらに、グラフ全体の傾向を説明したり、売上が減少した時期を整理したりすることも可能です。
このような機能は、営業レポートやマーケティング資料の分析に役立ちます。
ただし、画像から数値を読み取る際には誤差が生じる可能性があります。
正確な集計や計算を行う場合は、CSVやExcelなどの元データを使用する方が適しています。
画像についての質問応答
LLM Visionには、Visual Question Answering(VQA:視覚的質問応答)と呼ばれる機能があります。
これは、画像と質問文を組み合わせて、画像に関する回答を生成する技術です。
例えば、料理の写真を入力して「野菜は使われていますか?」と質問できます。
また、商品の画像を入力して「デザインの特徴を教えてください」と質問することも可能です。
画像について知りたい内容を自然言語で指定できるため、専門的な画像処理プログラムを作成しなくても情報を得られます。
複数の画像の比較
複数画像の入力に対応したモデルでは、画像同士の違いを比較できます。
例えば、2種類の広告バナーを入力して、配色、文字の大きさ、レイアウト、訴求内容などの違いを整理できます。
また、商品の新旧パッケージを比較し、変更された部分を説明することも可能です。
ただし、ピクセル単位での厳密な差分検出や正確な寸法比較には、専用の画像処理ツールが適している場合があります。
Webサイトやアプリの画面分析
LLM Visionは、Webサイトやアプリのスクリーンショットを解析できます。
例えば、Webページを入力すると、ヘッダー、メインビジュアル、見出し、画像、ボタンなどの配置を確認できます。
さらに、文字の読みやすさ、余白の使い方、配色、情報の優先順位などを分析し、改善案を生成できます。
ただし、スクリーンショットだけでは、ページの表示速度、実際の操作性、HTML構造、アクセシビリティの実装状況などを正確に判断できません。
これらの項目は、実際のWebページやコード、計測データを使って確認する必要があります。
動画の内容理解
動画入力に対応したマルチモーダルモデルでは、映像の内容を理解することもできます。
例えば、商品紹介動画の内容を要約したり、映像内で起きている出来事を説明したりできます。
動画解析には、複数のフレームを抽出して処理する方式や、時間的な情報を考慮して処理する方式などがあります。
また、モデルによっては音声情報を組み合わせて動画を理解することも可能です。
ただし、すべてのLLM Visionが動画入力に対応しているわけではありません。
動画の解析精度や対応機能は、モデルやシステムの構成によって異なります。
LLM Visionと従来の画像認識AIの違い
LLM Visionと従来の画像認識AIは、どちらも画像を処理する技術ですが、得意とする用途や設計思想が異なります。
| 比較項目 | 従来の画像認識AI | LLM Vision |
|---|---|---|
| 主な特徴 | 特定の画像処理に特化したモデルが多い | 視覚理解と言語処理を統合 |
| 得意な処理 | 画像分類、物体検出、領域分割など | 画像説明、質問応答、情報整理など |
| 自然言語への対応 | モデルや構成による | 対話形式の指示に対応しやすい |
| 出力形式 | 分類結果、座標、領域情報など | 文章、分類結果、構造化データなど |
| 汎用性 | 特定タスクに合わせた設計が多い | 幅広い視覚言語タスクに対応しやすい |
| 処理速度・精度 | 特定用途に最適化しやすい | モデルや用途によって異なる |
従来の画像認識AIの特徴
従来の画像認識AIには、画像分類、物体検出、画像領域分割など、特定の処理を目的としたモデルが数多くあります。
例えば、工場の製品検査では、製品の傷や欠陥を検出する専用モデルが使用されることがあります。
十分な学習データや適切なシステム設計があれば、限定された条件下で高い精度や処理速度を実現できます。
LLM Visionの特徴
LLM Visionは、画像から読み取った情報を自然言語による説明や分析に結び付けられる点が特徴です。
例えば、商品の写真を入力して「この商品の特徴を説明してください」と質問できます。
さらに、同じ画像について「どのようなターゲット層に訴求しやすいデザインですか?」といった分析も可能です。
ただし、こうした分析には推測が含まれるため、必ずしも実際のユーザー評価や市場データと一致するわけではありません。
LLM Visionは柔軟な対話や汎用的な画像理解に強みがありますが、特定の画像認識タスクでは専用モデルの方が適していることもあります。
LLM Visionの主な活用事例
LLM Visionは、さまざまな業界で業務効率化や情報分析の支援に活用できます。
Webマーケティングでの活用
Webマーケティングでは、Webページのスクリーンショットや広告クリエイティブの分析に利用できます。
例えば、ランディングページの画像から、ファーストビューの構成、キャッチコピーの見やすさ、CTAボタンの視認性などを確認できます。
また、複数の広告バナーを比較し、デザインや訴求内容の違いを整理することも可能です。
SEOに関連する業務では、画像内容の説明文や代替テキストの下書き作成にも活用できます。
ただし、画像の分析結果だけで検索順位やコンバージョン率の改善を保証できるわけではありません。
実際の改善効果を確認するには、アクセス解析やA/Bテストなどと組み合わせることが重要です。
ECサイトでの活用
ECサイトでは、商品画像から視覚的な特徴を抽出し、商品情報の整理を支援できます。
例えば、洋服の写真から色、柄、シルエット、デザイン上の特徴などを説明できます。
これらの情報をもとに、商品説明文や検索用キーワードの候補を作成することも可能です。
ただし、素材の正確な組成、寸法、製造国など、画像だけでは確認できない情報を推測で補わないよう注意が必要です。
文書処理での活用
企業の文書処理では、請求書、領収書、申込書などの画像から必要な情報を抽出できます。
例えば、請求書の画像から日付、取引先名、金額、項目名などを読み取り、一覧表に整理することが可能です。
また、読み取った文書の内容を要約する用途にも利用できます。
ただし、金額や日付の誤認識は業務上の問題につながるため、検証処理や人による確認が必要です。
製造業での活用
製造業では、設備や製品の写真を解析し、外見上の特徴や異常の可能性を整理する用途があります。
例えば、製品の写真から目立つ傷や汚れについて説明したり、設備の外観から確認すべき箇所を挙げたりできます。
ただし、画像から内部の故障原因を特定できるとは限りません。
製品の合否判定や設備の安全確認には、専用の検査システムや専門家による判断が重要です。
教育分野での活用
教育分野では、教科書の図表や問題文、手書きの解答などを入力して、内容を説明させることができます。
例えば、数学の図形問題について、図の意味を整理しながら解法を説明できます。
また、理科の実験図や歴史資料などをわかりやすく解説する用途にも活用できます。
ただし、数式や図形の位置関係を読み間違える場合があるため、重要な内容については検算や原資料との照合が必要です。
LLM Visionのメリット
LLM Visionには、画像理解と言語処理を組み合わせることによる複数のメリットがあります。
画像を直接入力できる
LLM Visionでは、画像の内容をユーザーが文章に書き起こさなくても、画像そのものを入力できます。
例えば、Webデザインについて相談する際、ページの構成を細かく説明する代わりに、スクリーンショットを入力できます。
これにより、画像に含まれる色や配置などの情報を直接参照した回答を得られます。
自然言語で質問できる
専門的な画像処理プログラムを作成しなくても、自然言語で質問できます。
例えば「この画像の特徴をまとめてください」「見やすさを改善する方法を教えてください」といった指示を使用できます。
この柔軟性は、画像解析をさまざまな業務で活用しやすくするメリットです。
複数の処理を組み合わせられる
LLM Visionは、画像の認識、情報の整理、文章の生成などを組み合わせられます。
例えば、画像内の文字を読み取り、その内容を要約し、さらに改善案を提案することが可能です。
複数の処理を一連の流れで実行できるため、業務効率化につながる可能性があります。
幅広い用途に活用できる
LLM Visionは、商品情報の整理、資料分析、デザインレビュー、教育支援など、幅広い用途で利用できます。
汎用的なモデルを使用することで、複数の視覚言語タスクを同じシステムで処理できる場合があります。
ただし、処理速度や精度、コストの面では、用途に特化した専用モデルの方が適しているケースもあります。
LLM Visionのデメリットと課題
LLM Visionは便利な技術ですが、精度やコスト、セキュリティなどの面で注意点があります。
画像認識の精度に限界がある
LLM Visionは、すべての画像を正確に認識できるわけではありません。
特に、小さな文字、低解像度の画像、複雑な図表、重なり合った物体などは、認識が難しくなる場合があります。
また、物体の正確な個数や位置関係、画像内の細かな違いについても誤りが発生することがあります。
重要な情報を扱う場合には、元画像と回答内容を照合する必要があります。
ハルシネーションが発生する場合がある
ハルシネーションとは、AIが事実と異なる内容を、もっともらしく生成してしまう現象です。
LLM Visionでは、画像に存在しない物体を説明したり、読み取れない文字や数値を推測して回答したりする場合があります。
例えば、料理の写真から外観だけでは確認できない食材や調味料を挙げてしまう可能性があります。
そのため、画像から確認できる事実と、AIによる推測を区別することが重要です。
計算コストが増加する場合がある
画像を処理する場合、テキストだけを処理する場合よりも多くの計算資源が必要になることがあります。
特に、高解像度画像や大量の画像を使用する場合、処理時間やメモリ使用量、API利用料金が増加する可能性があります。
画像の解像度や処理方式によって、トークン消費量が変わるモデルもあります。
そのため、業務利用では精度だけでなく、コストや処理速度も考慮する必要があります。
個人情報や機密情報の管理が必要になる
画像には、個人情報や機密情報が含まれている場合があります。
例えば、契約書、社員証、顧客情報が表示された画面などを入力する際には、情報の取り扱いに注意が必要です。
企業で利用する場合には、利用サービスのデータ保持方針、アクセス制御、情報管理ルールなどを確認することが重要です。
専門的な判断には適さない場合がある
医療画像の診断、設備の故障判定、製品の精密検査など、高い専門性や正確性が求められる場面では、LLM Visionだけに依存しないことが重要です。
例えば、医療用画像の診断には、用途に適合した専門システムや医療従事者による判断が必要です。
LLM Visionは情報整理や補助的な分析には役立ちますが、すべての専門的判断を代替できるわけではありません。
LLM Visionを効果的に活用する方法
LLM Visionの性能を引き出すためには、画像の品質や質問方法を工夫することが重要です。
鮮明で見やすい画像を使用する
画像が不鮮明な場合、文字や物体を正しく認識できない可能性があります。
そのため、できるだけ鮮明で、確認したい対象がはっきり写っている画像を使用することが望ましいでしょう。
細かい文字を含む文書やグラフでは、必要に応じて対象部分を拡大した画像を追加する方法も有効です。
質問内容を具体的にする
曖昧な指示よりも、分析してほしい内容を具体的に指定した方が、目的に合った回答を得やすくなります。
例えば、Webページのスクリーンショットを分析する場合は、以下のような指示が考えられます。
添付したWebページのスクリーンショットを、以下の観点から分析してください。
- ファーストビューの情報設計
- 見出しや文字の読みやすさ
- CTAボタンの視認性
- 配色と余白の使い方
- 改善が考えられるポイント
画像から確認できる事実と、推測に基づく改善提案を分けて説明してください。
画像から確認できない情報は、推測で断定しないでください。
このように分析項目を指定することで、回答の方向性を明確にできます。
出力形式を指定する
LLM Visionでは、画像から読み取った情報を、表形式やJSON形式で整理できる場合があります。
例えば、領収書の画像について、日付、金額、店舗名などの項目を指定し、決められた形式で出力させることができます。
ただし、出力形式が整っていても、抽出した情報の正確性が保証されるわけではありません。
特に金額や日付などの重要な情報については、検証する必要があります。
不明な情報を推測しないよう指示する
LLM Visionの誤回答を減らすには、画像から確認できない内容を推測しないように指示する方法があります。
例えば「画像から読み取れない情報は、不明と回答してください」と指定します。
ただし、このような指示を与えても、ハルシネーションを完全に防げるわけではありません。
必要に応じて、別のツールによる確認や人による検証を組み合わせることが重要です。
画像認識と他のツールを組み合わせる
業務に必要な精度を高めるには、LLM Visionだけでなく、他のツールと組み合わせる方法が有効です。
例えば、文書処理では専用OCRを使用して文字を抽出し、その結果をLLMで整理できます。
また、グラフの分析では、画像から傾向を把握するだけでなく、元の数値データを利用して正確な計算を行う方法が適しています。
このように、各技術の得意分野を組み合わせることで、より実用的なシステムを構築できます。
LLM Visionの今後の展望
LLM Visionは、マルチモーダルAIの研究開発とともに進化している分野です。
今後は、画像理解の精度向上に加えて、動画解析やAIエージェントとの連携など、さまざまな方向への発展が期待されます。
動画やリアルタイム映像への対応
画像だけでなく、動画やカメラ映像を処理する技術の発展によって、視覚情報を使ったAIの活用範囲が広がる可能性があります。
例えば、映像の内容を確認しながら質問に回答したり、作業状況を分析したりする用途が考えられます。
ただし、リアルタイム処理の性能や対応する機能は、モデルやシステムの構成によって異なります。
AIエージェントとの連携
LLM Visionは、AIエージェントとの連携においても重要な技術です。
AIエージェントとは、目標に応じて情報を収集したり、ツールを操作したりしながら、タスクの実行を支援するシステムです。
視覚情報を扱えるAIエージェントでは、画面のスクリーンショットなどを解析し、操作対象を判断することができます。
例えば、アプリの画面からボタンや入力欄の位置を把握し、ユーザーの指示に従って操作する仕組みが考えられます。
ただし、誤認識による意図しない操作を防ぐため、権限管理や重要操作の確認が必要です。
専門システムとの連携
今後は、LLM Vision単体の性能向上だけでなく、OCR、物体検出、検索システム、データベースなどとの連携も重要になると考えられます。
例えば、専用の画像認識モデルで物体を検出し、その結果をLLMが自然言語で説明するシステムが考えられます。
それぞれの技術の強みを組み合わせることで、より高い精度や効率が求められる業務にも対応しやすくなるでしょう。
まとめ
LLM Visionは、大規模言語モデルに画像などの視覚情報を扱う能力を組み合わせた技術や機能です。
代表的な方式では、Vision Encoderによって画像の特徴を数値表現に変換し、その情報をLLMと統合することで、画像に基づく回答を生成します。
画像に写っている物体の認識、画像内の文字の読み取り、グラフの分析、複数画像の比較、Webサイトのスクリーンショットの解析など、幅広い用途に活用できます。
また、自然言語による質問に対応できるため、専門的な画像処理プログラムを作成しなくても、視覚情報を活用した分析や情報整理を行いやすくなる点が特徴です。
一方で、画像認識の誤りやハルシネーション、計算コスト、セキュリティなどの課題も存在します。
そのため、LLM Visionを業務で利用する際には、画像から確認できる事実とAIによる推測を区別し、重要な情報については必ず検証することが大切です。
LLM Visionは、画像理解と言語処理を結び付ける技術として、今後のマルチモーダルAIやAIエージェントの発展においても重要な役割を果たすと考えられます。
以上、LLM Visionの仕組みやできることについてでした。
最後までお読みいただき、ありがとうございました。